[DB]B-Tree vs B+Tree(관계형 데이터베이스가 B+Tree를 선택하는 이유)
B-Tree
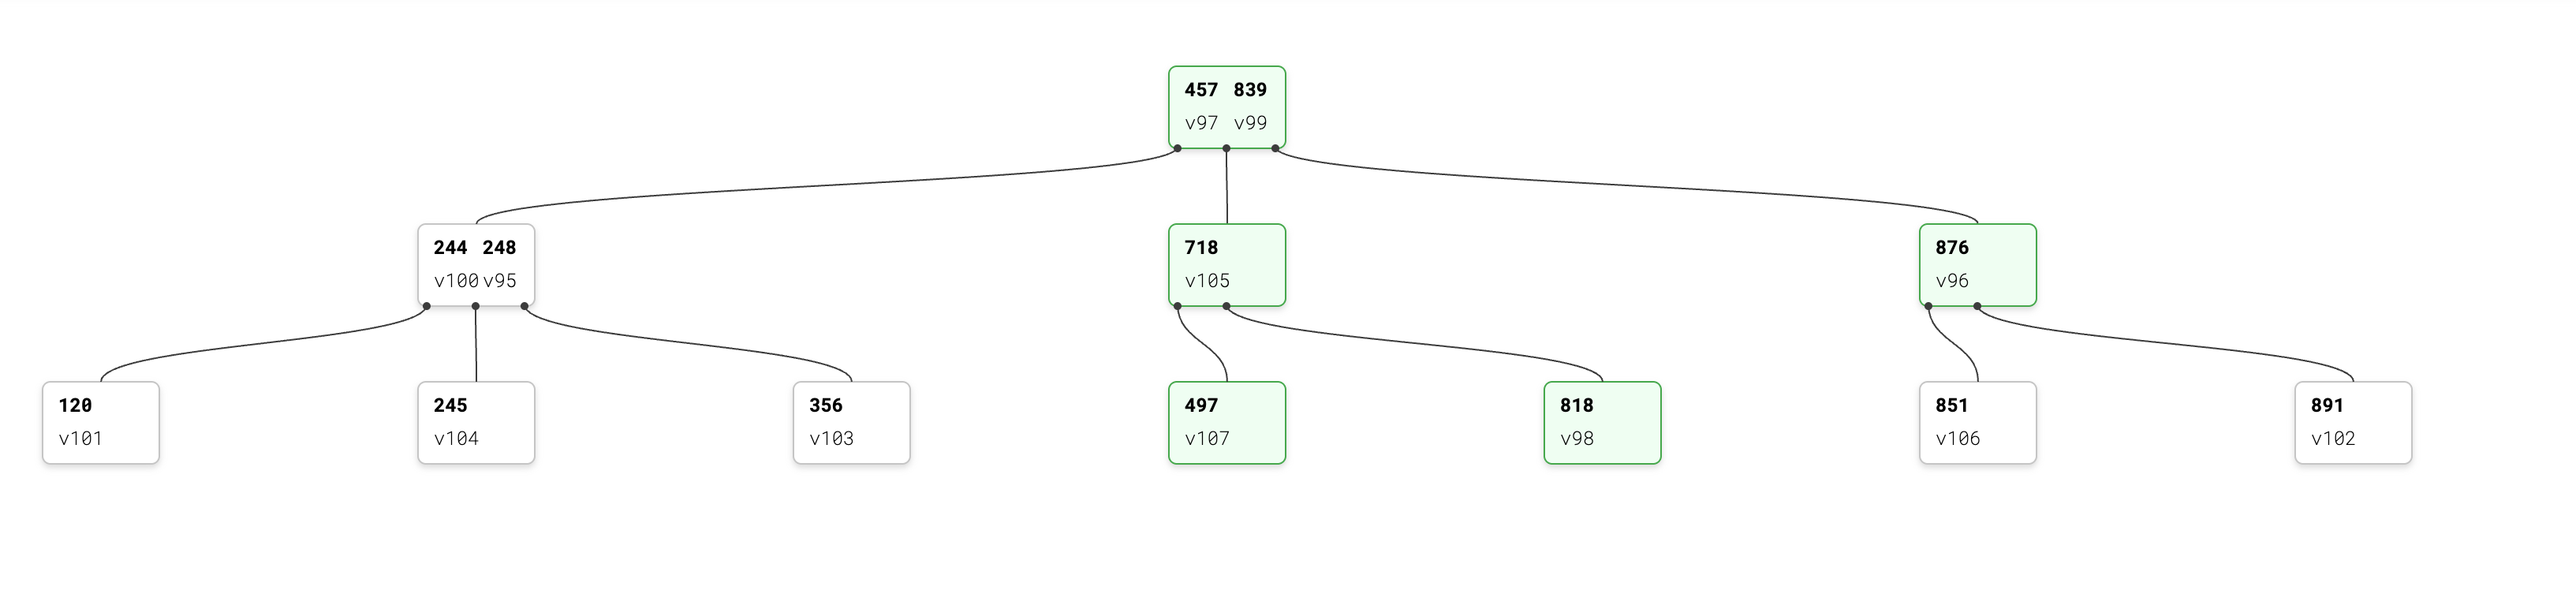
- 위 사진은 3차 B-Tree(즉 차수가 3인 B-Tree -> 자식을 최대 3개 가질 수 있다.)
- 여기서 차수는 각 노드가 가질 수 있는 최대 자녀 수를 의미 : M (기준 파라미터)
- 각 노드의 최대 키 갯수: M-1
- 각 노드의 최소 자녀 노드 수 : ⌈M/2⌉ (각 노드의 키 값이 M개가 되면 split을 해야하기 때문)
- 각 노드의 최소 키 갯수 : ⌈M/2⌉-1 (root, leaf 노드 제외)
- 모든 leaf노드는 동일한 level에 있다. → balanced tree → 검색시 avg/worst case 시간 복잡도가 O(log N)
- 노드 안에 key와 data가 있다. (여러개 가능)
# 삽입
- 무조건 leaf노드에 추가된다.
- 노드가 넘치면 가운데 key를 기준으로 좌 우 key들을 분할한다. → 이때 가운데 키는 부모노드로 올라가게 된다. → 이때 부모 노드도 넘친다면 해당 과정을 넘치지 않을 때까지 반복해서 진행
아래 사이트를 통해 직접 트리를 생성하면 바로 이해된다.
https://www.cs.usfca.edu/~galles/visualization/BTree.html
B+Tree
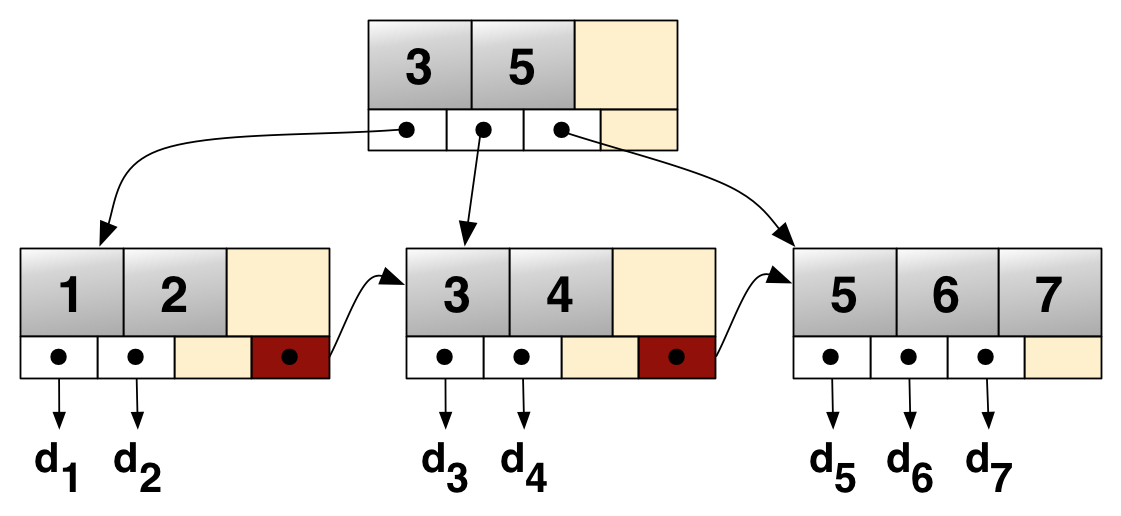
- B-Tree는 각 노드의 키마다 실제 데이터를 함께 저장한다.
- 하지만 B+Tree는 leaf노드에만 데이터를 저장한다. → leaf노드가 아니라면 자신의 키 값과 자식 노드 포인터를 가지고 있다.
- leaf노드의 부모 key는 리프노드의 첫번째 key보다 작거나 같을 수 있기 때문에 중복되는 key가 발생할 수 있다.
- 리프 노드들은 연결 리스트(Linked List) 형태로 서로 연결되어 있어,인접한 다음 리프 노드로 순차 접근(범위 탐색)이 매우 빠르다.
- 즉 모든 데이터는 리프 노드에 모여있게 된다.
아래 사이트에서 직접 생성해보면 바로 이해된다.
https://www.cs.usfca.edu/~galles/visualization/BPlusTree.html
B-Tree, B+Tree 비교
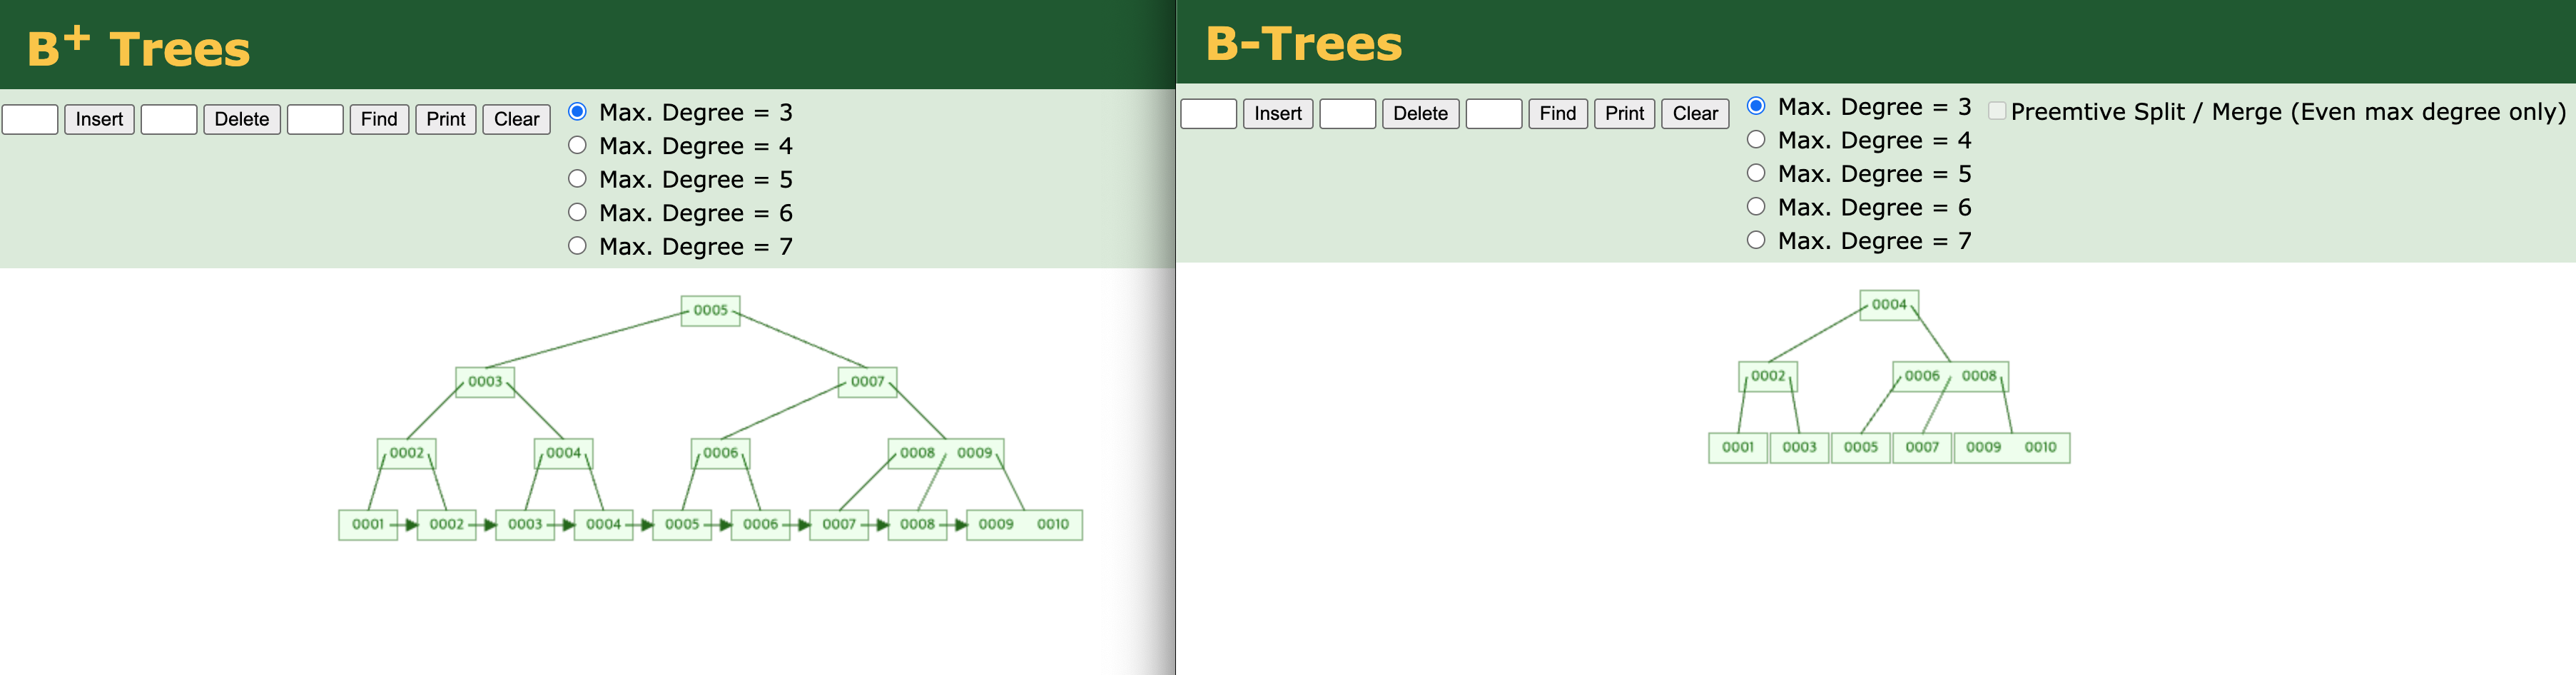
위 사진은 1부터 10까지의 key를 B-Tree와 B+Tree에 추가한 사진이다.
이때 key 4를 찾는다고 가정하면 B-Tree는 루트노드에 있기에 한번에 찾을 수 있다. 반면, B+Tree는 모든 데이터가 리프 노드에만 존재하기 때문에, 내부 노드에서 키를 발견하더라도 리프 노드까지 반드시 내려가야 한다.
따라서 이론적으로는 단일 키 탐색 시 B-Tree가 더 빠를 수 있다.
-> 다만 실전에서는 B+Tree가 내부 노드에 데이터를 저장하지 않기 때문에 동일한 페이지 크기에서 더 많은 키를 담을 수 있고, 그 결과 트리의 차수가 커져 높이가 낮아진다.
이번에는 범위 탐색을 고려해보자.
예를 들어 1 < key < 5 범위의 데이터를 찾는 경우, B+Tree는 key 2가 저장된 리프 노드에 한 번 도달하면,
리프 노드들이 연결 리스트 형태로 이어져 있기 때문에 인접 노드를 따라가며 2, 3, 4를 연속적으로 빠르게 탐색할 수 있다.
반면, B-Tree는 리프 노드 간 연결이 없으므로 각 키를 개별적으로 찾아야 하며, 이는 곧 각 key마다 루트에서 리프까지 재탐색해야 함을 의미한다.
+ 왜 AVL Tree 대신 B-Tree 계열을 DB인덱스로 사용할까?
AVL Tree는 각 노드에 하나의 키만 저장하므로 트리의 높이가 커지고, 그만큼 디스크 접근 횟수(I/O)가 많아진다.
반면 B-Tree는 한 노드(하나의 디스크 블록)에 여러 키와 자식 포인터를 저장하므로, 한 번의 블록 접근으로 훨씬 더 많은 키 범위를 커버할 수 있다.
이 덕분에 레벨이 내려갈 때마다 탐색 범위를 크게 줄일 수 있으며, 결과적으로 트리의 높이가 낮아지고 디스크 I/O 횟수도 크게 감소한다.
따라서 모든 관계형 데이터베이스는 B-Tree계열(B+Tree)을 DB 인덱스로 사용하고있다.