[카카오테크 부트캠프] 부하테스트 회고
백엔드 병목과 개선 사항
1) N+1 문제 제거 (Room 참가자 조회)
개선 전에는 방 참가자 정보를 만들 때, 참가자마다 findById()를 호출해 참가자 수만큼 DB 왕복(N+1)이 발생했다. 개선 후에는 참가자 ID를 모아 findAllById()로 한 번에 조회하도록 변경했다.
// 개선: participantIds를 모아 findAllById 한 번으로 조회 후 변환.
List<String> participantIds = room.getParticipantIds() == null
        ? List.of()
        : room.getParticipantIds().stream().toList();

List<User> participants = participantIds.isEmpty()
        ? List.of()
        : userRepository.findAllById(participantIds);

List<UserResponse> participantSummaries = participants.stream()
        .filter(p -> p != null && p.getId() != null)
        .map(UserResponse::from)
        .toList();
2) Page → Slice 전환 (채팅 히스토리 조회)
채팅 메시지 조회는 전체 개수가 필수 정보가 아니다. 그런데 Page<T>를 반환하면 Spring Data JPA는 다음 두 가지 정보를 모두 채워야 한다.
- 현재 페이지 데이터 조회 쿼리 1번
COUNT(*)쿼리 1번
즉, 내부적으로 2번의 쿼리가 발생한다. 이를 Slice<T>로 바꿔 count 쿼리를 제거했다.
// 옛날 버전 (Page 사용)
Page<Message> findByRoomIdAndIsDeletedAndTimestampBefore(
        String roomId,
        Boolean isDeleted,
        LocalDateTime timestamp,
        Pageable pageable
);

// 개선 버전 (Slice 사용)
Slice<Message> findByRoomIdAndIsDeletedAndTimestampBefore(
        String roomId,
        Boolean isDeleted,
        LocalDateTime timestamp,
        Pageable pageable
);
Slice는 pageSize + 1개를 조회해 다음 페이지 존재 여부(hasNext)만 판단한다.
3) 읽음 처리(updateReadStatus) N번 저장 → 1번 업데이트
개선 전에는 “이 유저가 메시지 리스트를 읽었다” 이벤트가 들어오면 메시지를 하나씩 가져와 readers 안에 유저가 있는지 자바에서 검사하고, 없으면 추가한 뒤 메시지마다 save()를 수행했다. 즉, 메시지 수만큼 반복 업데이트가 발생했다.
개선 후에는 MongoDB에 조건 업데이트를 한 방에 요청했다.
Query query = Query.query(
        Criteria.where("_id").in(messageIds)
                .and("readers.userId").ne(userId)
);

// 이미 읽은 메시지는 제외한 뒤, 남은 메시지들에 대해 readers 배열 업데이트를 한 번에 수행
mongoTemplate.updateMulti(query, update, Message.class);
4) Rooms API의 N+1 제거 (creator + participants 프리로드)
방 목록을 내려줄 때, 방 1개마다 creatorId/participantIds를 매번 조회하면 방 개수 × (1 + 참가자 수) 만큼 DB 왕복이 발생한다.
개선 후에는 방 목록 처리 전에 creator + participants의 userId를 전부 모아 다음 방식으로 처리했다.
Set<String>으로 중복 제거findAllById(userIds)한 번으로 로딩Map<userId, User>로 캐싱
5) 메시지 리액션 처리 성능/동시성 개선 (findAndModify)
개선 전 방식은 다음 순서로 동작했다.
findById(messageId)로 문서 전체 읽기- 자바 객체에서 reactions 수정
save(message)로 문서 전체 저장
문제점은 다음과 같다.
- 네트워크 왕복: 읽기 + 쓰기 2회
- 불필요한 payload: 문서 전체 전송
- 동시성 문제: 여러 사용자가 동시에 리액션하면 overwrite 가능(원자성 부족)
개선 후에는 findAndModify로 찾기 + reactions 필드 수정 + 결과 반환까지 원자적으로 처리하도록 변경했다.
효과:
- 호출 2회 → 1회
- 문서 전체 저장 → 특정 필드만 업데이트
- 동시성 안전성 향상(atomic)
6) 다중 WAS 환경에서 Redis가 필요한 이유
Socket.IO 서버를 수평 확장하면 각 WAS 인스턴스는 서로의 소켓을 모른다. Redis Pub/Sub를 중간 버스로 사용하면 서버 A로 들어온 이벤트를 Redis 채널에 publish 하고, 서버 B도 subscribe 하여 자기 쪽 클라이언트로 재전송할 수 있다.
Redis Pub/Sub가 없으면:
- “같은 room”이라도 인스턴스가 다르면 이벤트가 전달되지 않아 메시지 유실이 발생한다.
- 세션/레이트리밋/캐시를 로컬에 두면 인스턴스별로 분리되어 일관성이 깨진다.
또한 운영 리스크를 줄이기 위해 Redis를 아래처럼 분리했다.
- 세션/레이트리밋용 Redis
- 캐시/Socket PubSub용 Redis
7) 금칙어 필터링 로직 개선 (Aho–Corasick)
금칙어 검출이 단순 반복 탐색 구조면(사전 전수 검색), 메시지 길이/사전 크기가 늘어날수록 CPU 사용량이 급증한다. 이를 Aho–Corasick 기반 트라이로 재구현해 메시지 길이에 선형으로 검사하도록 개선했다.
효과:
- 1만+ 단어 사전에서도 전수 검색 제거
- CPU 사용량과 응답 지연 감소
- 금칙어 검출 시 DB 호출 전에 차단하여 불필요한 I/O 최소화
성능 비교
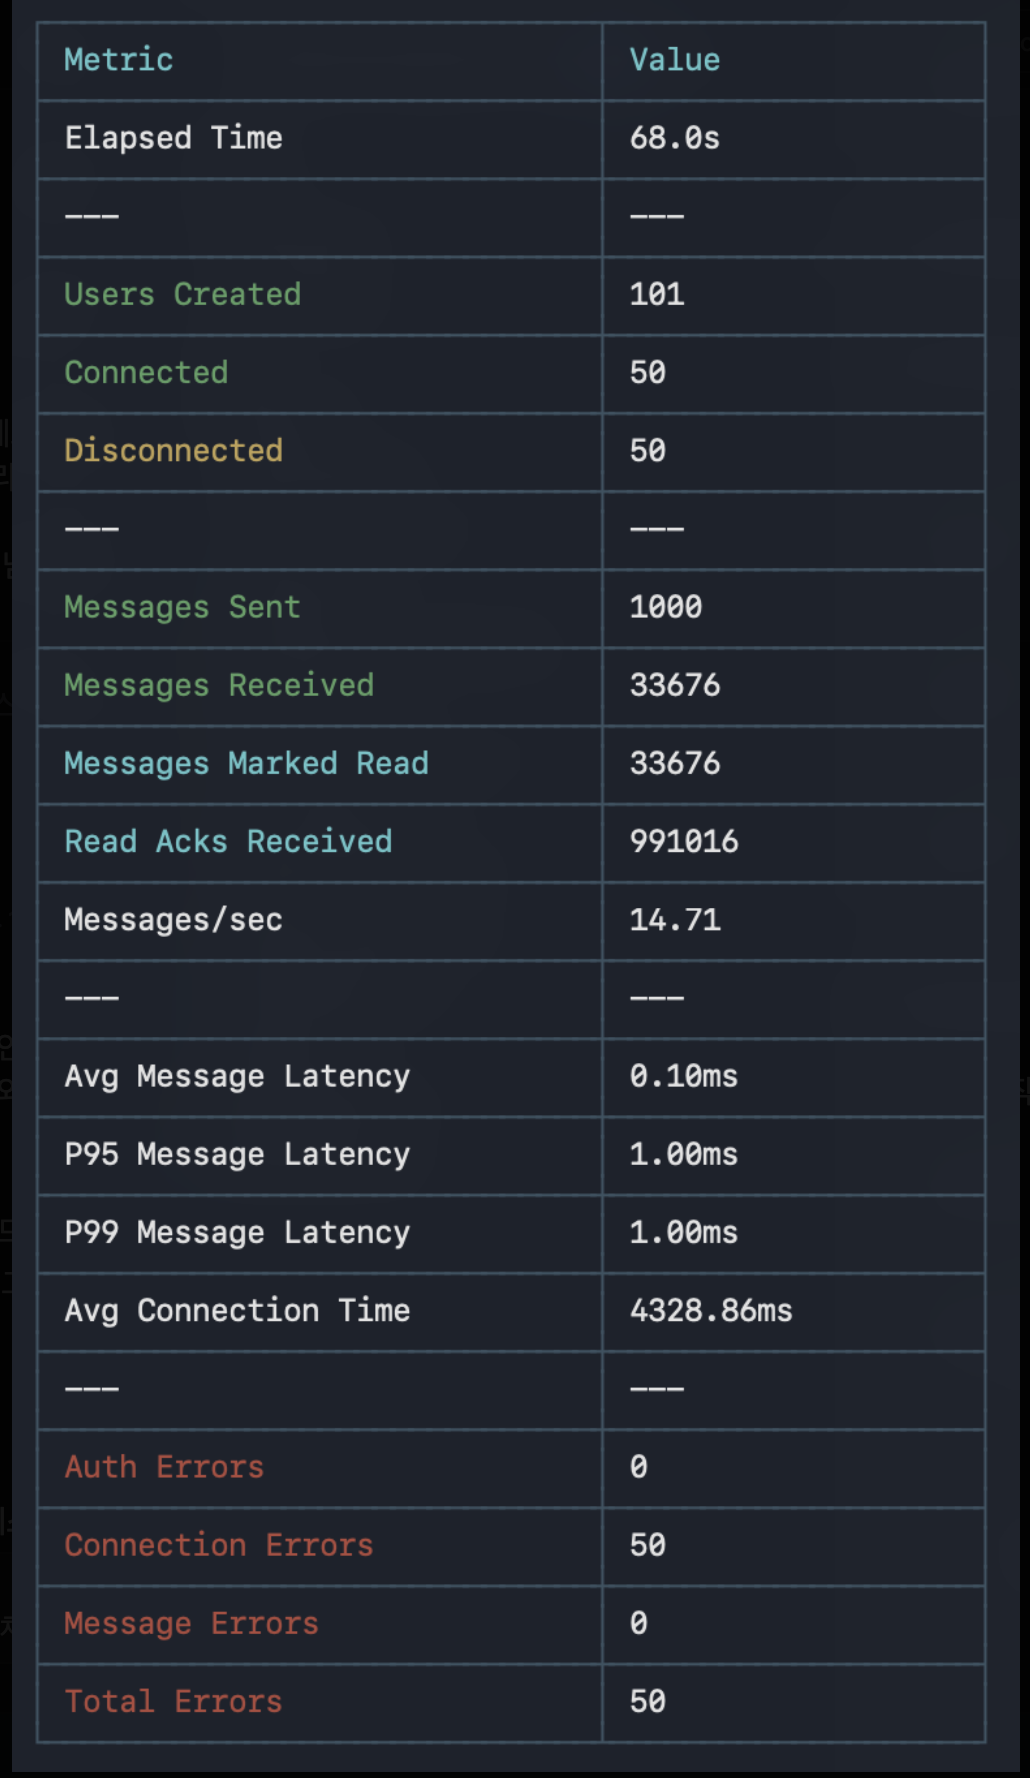
아키텍쳐 - was 1, db 1
유저 - 100명
배치 당 - 20명
배치 지연 - 1초
1명 당 메시지 - 20개
기존 코드
개선 이후
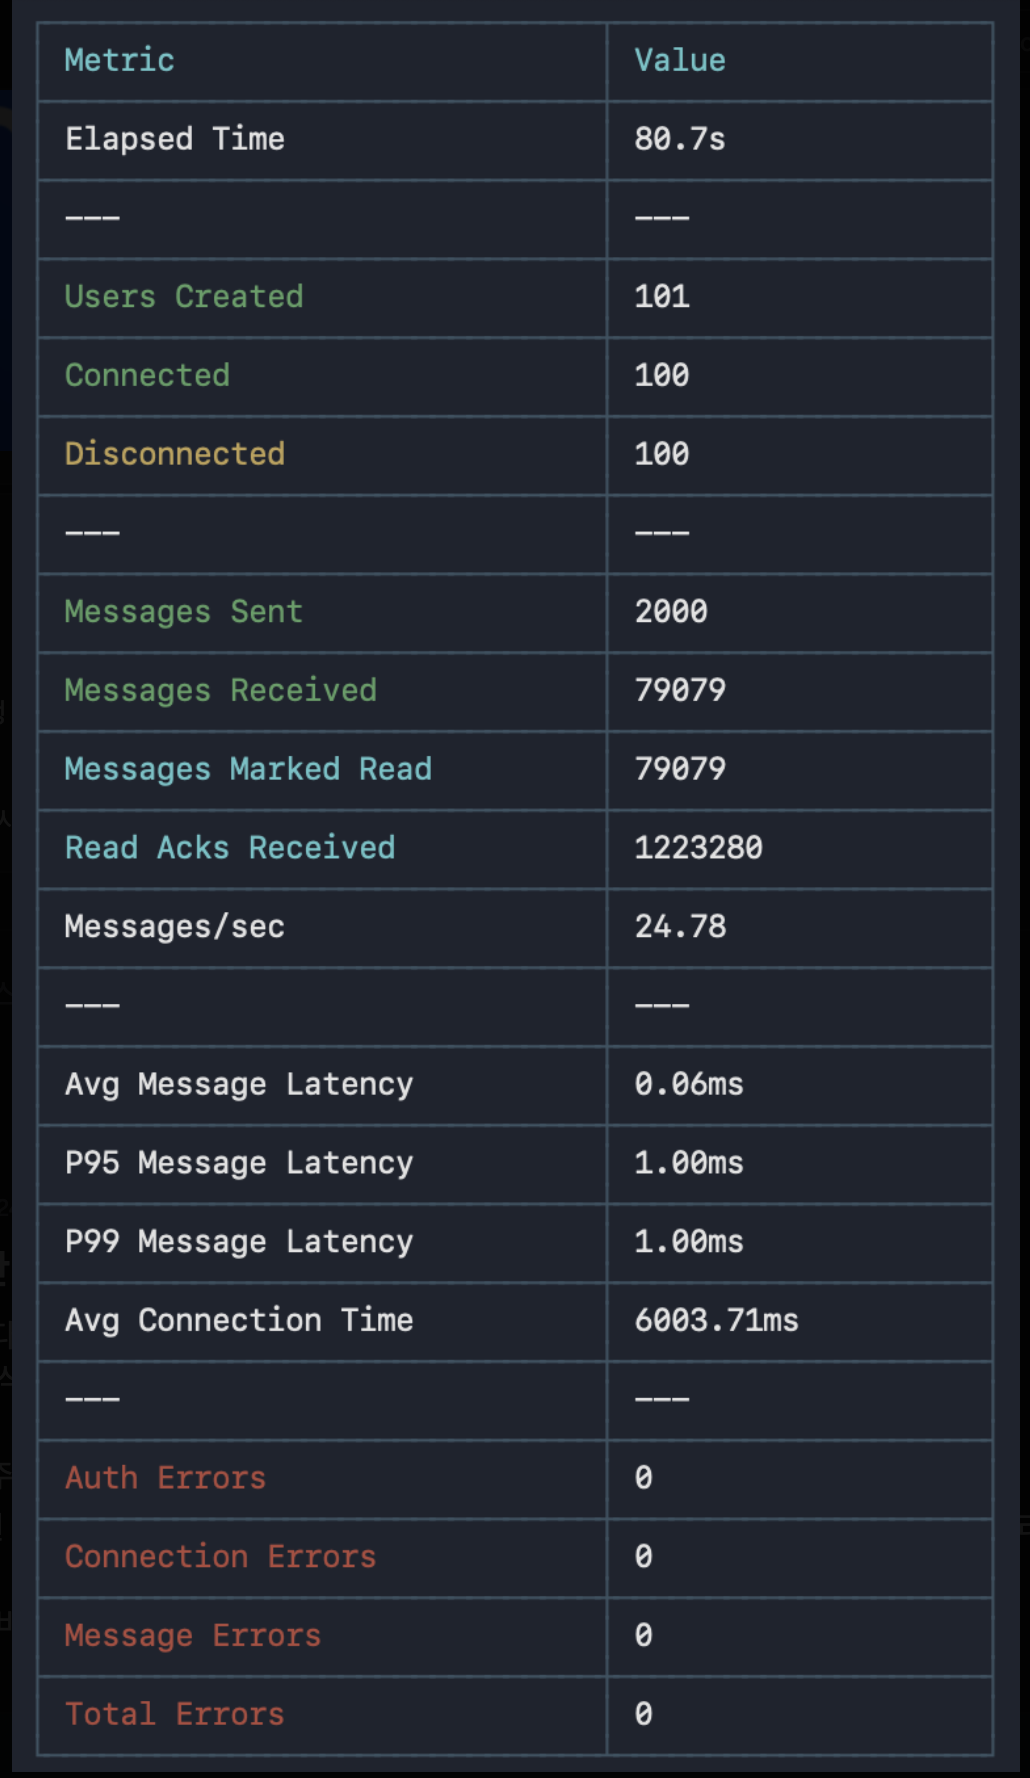
결과
부하테스트 결과 운이 좋게도 1등을 하게 되었다.